

Die gefährlichste Antwort ist die, die früher einmal wahr war: Was wir beim Aufbau einer KI für die Nachhaltigkeitsberichterstattung gelernt haben: Das Schwierige war nie, eine Antwort zu generieren. Es ging vielmehr darum, dem System beizubringen, wann eine zuvor genehmigte Antwort nicht wiederverwendet werden darf.
Kurz gesagt: Die Wiederverwendung der im Vorjahr genehmigten Nachhaltigkeitsangaben funktioniert nur, wenn die Software weiß, wann eine Wiederverwendung unzulässig ist. Das Company Knowledge Profile von Glacier speichert jede genehmigte Antwort zusammen mit ihrer Identität: Frage, Unternehmen, Berichtszeitraum, Abgrenzung, Nachweis und Genehmiger. Deterministische Regeln überprüfen diese Identität, bevor ein KI-Modell darauf zurückgreifen darf, und protokollieren jede Ablehnung.
Jedes Frühjahr genehmigt bei Tausenden von Unternehmen in ganz Europa jemand einen Satz wie diesen:
Die Brutto-Treibhausgasemissionen des Scope 1 beliefen sich auf 41.300 tCO₂e, berechnet innerhalb der operativen Kontrollgrenze. Kältemittelverluste werden ab 2024 berücksichtigt.
Bis zur Genehmigung wurde dieser Satz anhand von Belegen entworfen, diskutiert, anhand des Regelwerks überprüft und von einer Person unterzeichnet, deren Name Gewicht hat. Er ist das Wertvollste, was die Berichterstattungssoftware das ganze Jahr über hervorgebracht hat. Nicht wegen der Zahl, sondern wegen der damit verbundenen Beurteilung: diese Zahl, für dieses Unternehmen, in diesem Jahr, auf dieser Grundlage. Dann ändert die Software den Status von „in Prüfung“ auf „genehmigt“ und behält nichts weiter zurück.
Zwölf Monate später taucht dieselbe Frage wieder auf. Das neue Berichtsprojekt beginnt mit einer leeren Seite, und das Team fängt von Grund auf an, die Unternehmensdokumente zu lesen, als hätte noch niemand diese Frage beantwortet.
Wir entwickeln Glacier AI, eine KI-Plattform für die Nachhaltigkeitsberichterstattung gemäß den europäischen CSRD-Vorschriften, bei der ein einziger Berichtszyklus die Beantwortung von rund tausend strukturierten Fragen bedeutet. Irgendwann mussten wir uns etwas Unangenehmes eingestehen: Das stärkste Signal, das unser Produkt je erzeugt hat – nämlich dass ein Mensch eine Antwort unter bestimmten Bedingungen genehmigt – wurde in dem Moment verworfen, in dem es auftauchte.
Also haben wir das „Company Knowledge Profile“ (CKP) entwickelt: ein dauerhaftes Gedächtnis darüber, was ein Unternehmen gesagt hat, wer dahinterstand und unter welchen Bedingungen es zutraf. Das Gedächtnis aufzubauen, stellte sich als der einfache Teil heraus. Der schwierige Teil bestand darin, ihm beizubringen, wann es nicht antworten darf.
Semantische Suche ist kein Gedächtnis
Der naheliegende Weg, sich an frühere Arbeiten zu erinnern, ist die semantische Suche. Man indexiert die im letzten Jahr genehmigten Antworten, ruft alles ab, was der diesjährigen Frage ähnelt, und lässt ein Sprachmodell daraus einen Entwurf erstellen. In einer Demo funktioniert das wunderbar.
Es scheitert aber auch auf besonders unauffällige Weise. Für eine Ähnlichkeits-Engine sind Scope-1-Emissionen im Jahr 2025 und Scope-1-Emissionen im Jahr 2024 fast dasselbe. Ebenso wie eine Richtlinie und die Richtlinie, die sie ersetzt hat. Ebenso wie zwei Zahlen, die unter unterschiedlichen organisatorischen Rahmenbedingungen berechnet wurden und in fast identischen Sätzen stehen.
Der Fehler, um den wir uns Sorgen machen, ist niemals eine absurde Erfindung, die jeder bemerken würde. Es ist eine reale Zahl aus dem falschen Jahr. Eine gültige Antwort für die falsche Tochtergesellschaft. Eine genehmigte Aussage, die nach Regeln getroffen wurde, die sich inzwischen geändert haben. Sie liest sich perfekt, weil sie einst perfekt war.
Und keine noch so große Verbesserung der Modellqualität kann das beheben. Ein besseres Sprachmodell kann keinen Kontext wiederherstellen, den das umgebende System nie gespeichert hat. Der Kontext muss Teil des Wissens selbst werden.
Eine Antwort ist eine Aussage, kein Absatz
Jede genehmigte Antwort im Unternehmenswissensprofil (CKP) wird als Aussage mit einer Identität gespeichert, nicht als Textabsatz. Das CKP bewahrt den genehmigten Wortlaut auf, da die Vorbehalte und Einschränkungen Teil dessen sind, was die Antwort richtig gemacht hat. Aber es speichert niemals nur den Wortlaut allein. Jede Antwort wird zusammen mit ihrer Identität (welche Frage sie beantwortet, für wen, für welchen Zeitraum und auf welcher Grundlage) sowie den zugrunde liegenden Belegen und der Person, die sie genehmigt hat, gespeichert.
Das verändert die Frage, die die Software stellen muss. Nicht „Scheint diese alte Antwort relevant zu sein?“, sondern „Ist diese Aussage hier und jetzt gültig?“, eine Frage mit einer automatisierten Antwort.
Angenommen, das Unternehmen wechselt von einer operativen Kontrollgrenze zu einer finanziellen Kontrolle.
Die Zahl aus dem letzten Jahr bleibt im CKP erhalten. Sie ist Teil der Unternehmensgeschichte und hilft dem Menschen, die Veränderung zu verstehen. Aber sie kann nicht mehr stillschweigend als Grundlage für einen neuen Entwurf dienen. Die Identität stimmt nicht überein, und das System weiß das.
Die gleiche Disziplin gilt, wenn sich Wissen weiterentwickelt. Wenn eine spätere Genehmigung eine frühere korrigiert oder ein Standard überarbeitet wird, schreibt das CKP die Geschichte nicht um, um die Dinge ordentlich zu halten. Es behält die alte Position, die neue und die Beziehung zwischen beiden bei. Es gibt zwei Fragen, auf die ein Berichts-Team letztendlich eine Antwort benötigt, und es sind unterschiedliche Fragen: Wofür stehen wir heute, und woran haben wir an dem Tag geglaubt, an dem wir den Bericht eingereicht haben? CKP kann beide beantworten. Auf der Produktseite nennen wir dies den Nachweisweg: Jede Information enthält eine Quelle, einen Status und eine Genehmigung.
Das Modell schreibt. Es hat kein Stimmrecht.
Das ist die Arbeitsteilung, auf der das gesamte System aufbaut. Deterministische Regeln legen fest, woraus das Modell schreiben darf, und die Regeln sind streng in Bezug auf die Identität: Eine Antwort aus dem falschen Jahr wird abgelehnt, nicht umformuliert, und eine Antwort, deren Beleg zurückgezogen wurde, verliert damit ihre Gültigkeit.
Bis unser Sprachmodell Material zu Gesicht bekommt, hat die Plattform es bereits gefunden, seine Identität überprüft und zur Verwendung freigegeben. Das Modell tut das, was es wirklich gut kann: eine Frage interpretieren, freigegebenes Material zusammenführen und es gut formulieren. Es wird niemals aufgefordert, seine eigenen Belegquellen zu bestätigen.
Flüssigkeit ist keine Erlaubnis.
Ablehnung ist eine Funktion
Die meisten KI-Systeme sind darauf optimiert, etwas zurückzugeben. In der Nachhaltigkeitsberichterstattung verwandelt dieser Instinkt Unsicherheit in falsche Autorität, daher behandelt CKP die Ablehnung als ein erstklassiges, protokolliertes Ergebnis.
Wenn zwei genehmigte Aussagen im Widerspruch zueinander stehen, zeigt es den Konflikt auf, anstatt diejenige mit dem besseren Ähnlichkeitswert auszuwählen. Wenn ein Offenlegungscode zu zwei Standards gehören könnte (und Berichtsrahmenwerke Codes häufiger wiederverwenden, als es jedem lieb ist), überlässt es die Antwort einem Menschen, anstatt zu raten. Wenn keine genehmigte Aussage eine anwendbare Anforderung abdeckt, zeigt es eine Lücke klar und deutlich auf, anstatt sie zu vertuschen.
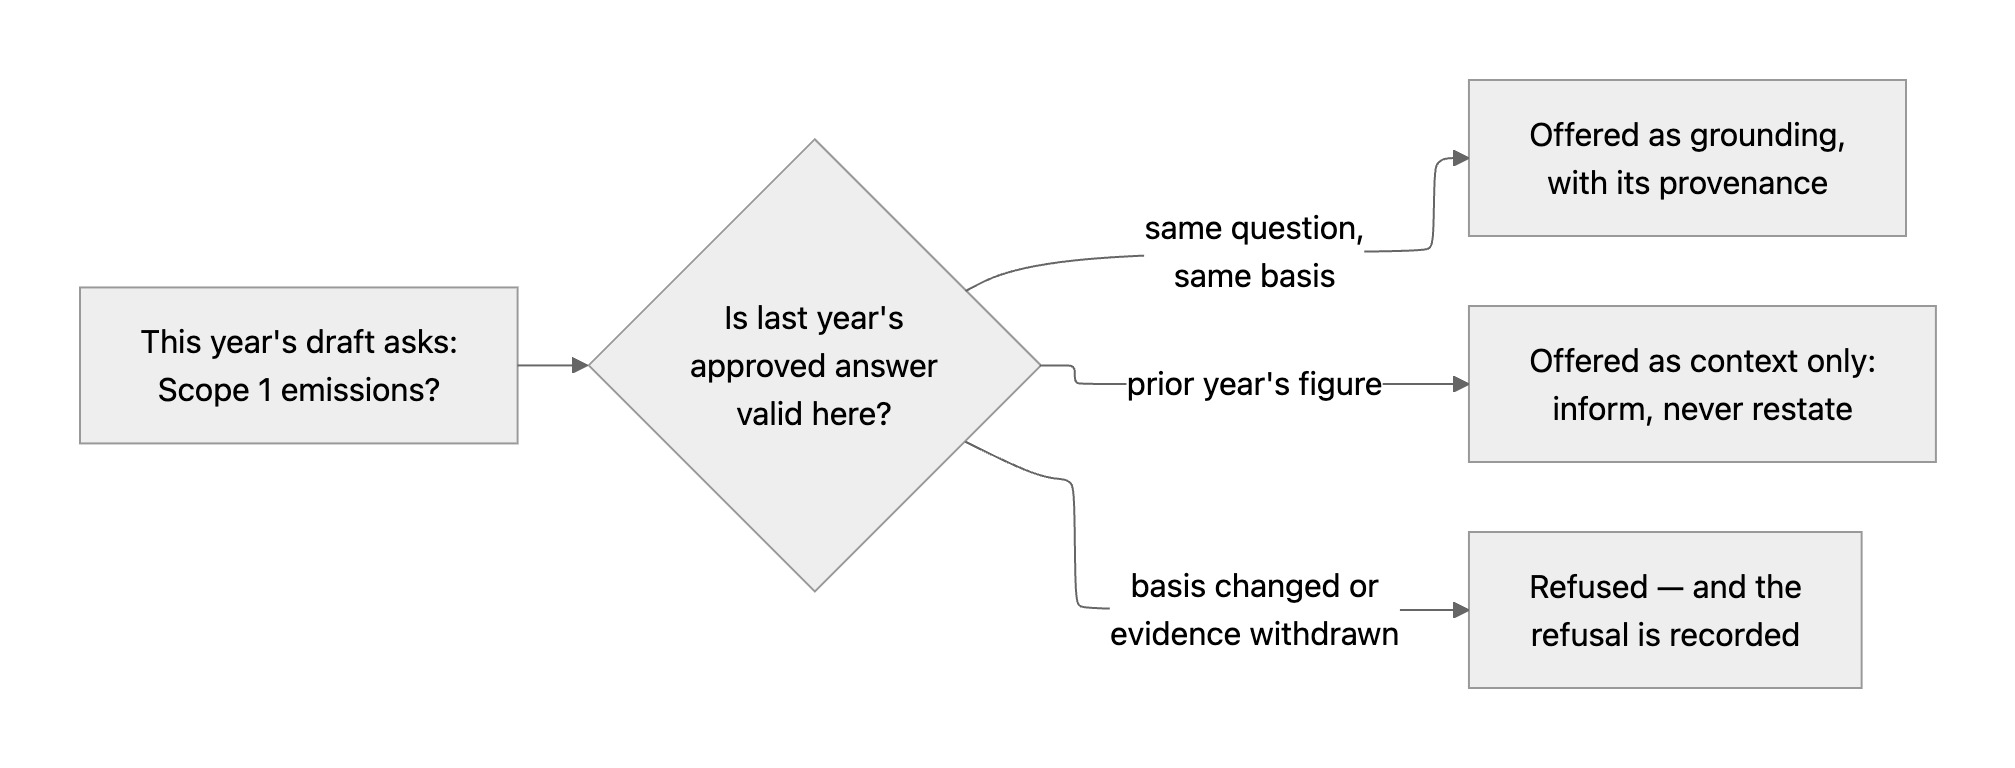
Der Moment, der das System auszeichnet: Wiederverwendung ist eine Entscheidung, und die Verweigerung ist eines seiner protokollierten Ergebnisse.
Jede dieser Ablehnungen bedeutet Arbeit für jemanden. Das ist beabsichtigt. Bei sicherheitsrelevanter Arbeit ist eine fehlende Antwort behebbar: Jemand überprüft die Warteschlange und klärt den Fall. Eine falsche Antwort verbreitet sich. Über einen Entwurf, vorbei an einem Prüfer, hinein in einen eingereichten Bericht, wo sie aufhört, ein Fehler zu sein, und zu einem Befund wird. Wenn wir die Wahl haben, entscheiden wir uns jedes Mal für den behebbaren Fehler.
Es gibt auch eine kommerzielle Variante dieses Arguments. „Unsere KI verwendet Ihre früheren Antworten wieder“ ist eine Behauptung, die jeder Anbieter aufstellen kann. „Unser System kann Ihnen schriftlich mitteilen, warum es die Wiederverwendung einer Antwort abgelehnt hat“, ist es nicht – und genau diese Behauptung ist es, die einem Prüfer tatsächlich wichtig ist.
„Es handelt sich also um einen Wissensgraphen?“
Technisch versierte Leser fragen an dieser Stelle meist, warum wir nicht einfach einen Wissensgraphen verwendet haben. Die ehrliche Antwort: In jeder Hinsicht, auf die es ankommt, ist es eines. Aber „Graph oder nicht“ war nie die interessante Frage. Die meisten Wissensgraphen sind darauf ausgelegt, so viel wie möglich zu wissen: alles aufnehmen, intensiv verknüpfen, einen Konfidenzwert zuweisen, akzeptieren, dass manche Kanten falsch sein werden. Das ist ein guter Kompromiss, wenn eine falsche Kante nur Rauschen ist. In unserer Welt ist eine falsche Kante eine Falschangabe mit einer lückenlosen Nachverfolgbarkeit.
Daher kehrt CKP die üblichen Prioritäten um. Die Herkunft ist keine nachträglich hinzugefügte Anmerkung; sie ist Teil der Aussage selbst. Mehrdeutigkeit wird nicht zu einer Dezimalbewertung; sie wird zu einer Aufgabe auf der Liste eines Verantwortlichen. Und das Fehlen von Informationen hat eine Bedeutung: Da CKP den vollständigen Fragenkatalog einer Norm kennt, kann es unterscheiden zwischen beantwortet, bewusst nicht gemeldet und tatsächlich fehlend. Genau diese Übersicht benötigt ein Berichterstatter im Januar, und ein Allzweck-Graph kann sie nicht erstellen.
Die meisten Diagramme sind darauf ausgelegt, so viel wie möglich zu wissen. CKP ist darauf ausgelegt, genau zu wissen, wie viel es weiß.
Ein Unternehmen sollte sich nicht jedes Jahr selbst vergessen müssen
So sieht das von der anderen Seite aus, im zweiten Jahr der Nutzung von Glacier. Die Entwürfe treffen bereits im Einklang mit dem ein, was man im letzten Jahr freigegeben hat. Ein Widerspruch zwischen dem diesjährigen Entwurf und den im letzten Jahr eingereichten Zahlen wird erkannt, bevor ein Mensch ihn liest. Wenn jemand fragt: „Warum steht in dieser Offenlegung 41.300?“, hängt die Antwort (welche Frage, welcher Zeitraum, welcher Nachweis, wessen Genehmigung) nicht mehr vom Gedächtnis einer einzelnen Person ab. Wenn zwei Teams unterschiedliche Antworten auf dieselbe Frage genehmigt haben, wird dies als zu lösender Konflikt sichtbar – und nicht als Überraschung bei einem Audit.
Die gleiche genehmigte Angabe ist zudem nicht mehr nur einmal verwendbar. Eine für den CSRD-Bericht freigegebene Zahl ist dieselbe Zahl, die im EcoVadis-Fragebogen abgefragt wird, und dieselbe Zahl, die ein ESG-Rating in einer anderen Form benötigt. Nur die Form der Frage ändert sich. Das ist der Aspekt des Company Knowledge Profile, der den Kunden als Erstes auffällt: einmal genehmigt, überall verwendbar.
Wir gehen vorsichtig mit dem Begriff „audit-taugliche KI“ um, denn diese Beurteilung obliegt den Auditoren, nicht den Softwareanbietern. Unsere Aussage ist enger gefasst und unserer Meinung nach nützlicher: Jedes Wissenselement, das unserer KI zur Verfügung gestellt wird, hat eine Identität, eine Historie und einen Grund, warum es dort vorhanden sein darf. Und wenn diese Dinge nicht festgestellt werden können, weist das System darauf hin.
Das Ziel war nie eine KI, die immer eine Antwort parat hat. Es ist ein Unternehmensgedächtnis, das weiß, wer was gesagt hat, wann es wahr war und wann es besser ist, zu schweigen.
Sehen Sie es in Ihrem eigenen Bericht
Wir nehmen einen bestehenden Nachhaltigkeitsbericht und zeigen, was zu einer wiederverwendbaren, genehmigten Antwort wird und was unser System nicht wiederverwenden will.
Das Unternehmenswissensprofil im Detail
Oder lesen Sie, wie das Unternehmenswissensprofil von Anfang bis Ende funktioniert – vom Einlesen Ihrer bestehenden Dokumente über Genehmigungsstufen bis hin zum Nachweispfad.
Häufig gestellte Fragen
Kann die KI Antworten aus der Nachhaltigkeitsberichterstattung des letzten Jahres wiederverwenden? Ja, aber nur unter bestimmten Bedingungen. Eine Wiederverwendung ist unbedenklich, wenn die neue Frage dieselben Merkmale aufweist wie die genehmigte Antwort: derselbe Berichtszeitraum, dieselbe Einheit und derselbe Umfang, dieselbe Grundlage sowie Nachweise, die weiterhin gültig sind. Glacier überprüft diese Bedingungen anhand deterministischer Regeln, bevor ein KI-Modell einen Entwurf auf der Grundlage einer früheren Antwort erstellt.
Warum versagt die semantische Suche bei der CSRD- und ESG-Berichterstattung? Die semantische Suche ordnet Ergebnisse nach Ähnlichkeit, und in der Berichterstattung sind gerade die ähnlichsten Einträge die gefährlichsten Kandidaten. „Scope 1 für 2024“ und „Scope 1 für 2025“ erscheinen einer Ähnlichkeits-Engine fast identisch, ebenso wie eine Richtlinie und deren Nachfolgeversion. Das Ergebnis liest sich perfekt, ist aber für den aktuellen Berichtszeitraum falsch.
Was ist ein Nachweispfad in der Nachhaltigkeitsberichterstattung? Ein Nachweispfad dokumentiert, woher eine offengelegte Zahl oder Aussage stammt: das Quelldokument, den Status dieser Quelle, wer die Aussage genehmigt hat und wann. Er ermöglicht es einem Berichtsteam, die Frage „Warum besagt diese Offenlegung genau das?“ zu beantworten, ohne sich auf das Gedächtnis einzelner Personen verlassen zu müssen, und er bleibt auch bei Personalwechseln zwischen den Berichtszyklen erhalten.
Was passiert, wenn ein Unternehmen seinen Berichtsrahmen ändert? Die vorherige Zahl verbleibt im Unternehmenswissensprofil als Teil der Unternehmenshistorie, kann jedoch nicht mehr stillschweigend als Grundlage für einen neuen Entwurf dienen. Ein Wechsel von der operativen zur finanziellen Kontrolle verändert die Grundlage der Aussage, sodass die Identität nicht mehr übereinstimmt und die Antwort nicht automatisch wiederverwendet wird.
Ist die KI von Glacier revisionssicher? Diese Beurteilung obliegt den Wirtschaftsprüfern, nicht den Softwareanbietern, daher erheben wir keinen solchen Anspruch. Was Glacier jedoch behauptet, ist enger gefasst: Jedes der KI zur Verfügung gestellte Wissenselement verfügt über eine Identität, eine Historie und einen dokumentierten Grund für seine Eignung. Wo diese nicht nachgewiesen werden können, lehnt das System ab und protokolliert die Ablehnung.